医療AIモデルが優れたテスト性能を示していても、初めて遭遇する本当に新しいデータセットでは機能しないことがあります。
原因が分布シフトである場合も、意図したワークフローの定義不足である場合もあります。しかし、さらに早い段階で別の問題が生じることがあります。評価データの情報が、気付かないうちにモデル開発へ入り込むことです。これがデータリークです。
リークは、答えを直接学習させるような明らかな誤りとは限りません。同一患者の画像を訓練セットとテストセットの両方へ入れる、データセット全体で前処理を適合させる、分割前に特徴量を選択する、チューニング中にテストセットを繰り返し確認する、同一検体からほぼ重複したエクスポートを異なる分割へ入れる、といった方法でも発生します。
その結果、独立して見える評価が実際には独立していなくなります。モデルは、すでに見た患者、取得条件、施設、開発上の判断を部分的に認識しているかもしれません。その場合、スコアが測るのは将来の利用に対する準備度ではなく、データセットへの慣れです。
リークの防止は、些細なデータサイエンス上の作業ではありません。技術、臨床、品質、プロダクトの各チームが確認し、信頼できるエビデンスを構築するための一部です。
テストセットが支えるべき主張から始める
すべての状況に当てはまる正しい分割比率や分割戦略はありません。適切な設計は、チームが評価したい主張によって決まります。
次のように問いかけてください。
このテストセットは、将来のどの状況を再現すべきか?
過去データに含まれる患者の新しい検査を支援するモデルであれば、将来の受診を分ける必要があるかもしれません。新しい病院へ導入する場合、施設を完全に保持した評価の方が有益かもしれません。新しいスキャナーモデルや調製プロトコルに遭遇するシステムであれば、それらの取得元を明示的に含めるか、専用のストレステストを用意する必要があります。
したがって、検証計画では最初に次を定義すべきです。
- 意図した用途
- ユーザーと支援する意思決定
- 予測単位
- 想定する導入対象集団
- 対象となる施設、装置、ワークフロー
- モデルを安全でない、または運用に不適切なものにする失敗モード
これは、データセット分割を検証を起点とする医療AIという、より広い問いへ結び付けます。よく使われる割合を採用したからといって、分割が信頼できるわけではありません。意図した主張に即した方法でモデルへ課題を与えるとき、その分割は信頼できるものになります。
真の独立単位を見つける
多くの場合、行は独立した観測ではありません。
医療データセットには、一般に次のような関係があります。
- 1人の患者から得た複数の画像
- 1枚のスライドから得た複数の視野
- 1つの検体から得た複数のスライド
- 1人の患者の反復受診
- 1枚の画像を拡張または再切り出しした複数の版
- 同じ装置、操作者、施設が生成した記録
- 同じ診療エピソード中に収集した測定値
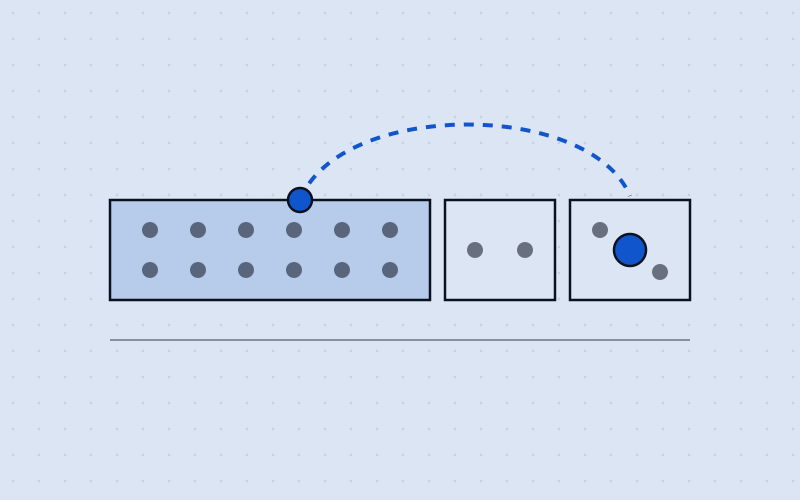
行単位のランダム分割では、関連する観測が評価境界の両側へ置かれる可能性があります。病理モデルが訓練時にある視野を見て、テスト時に同じスライドの別の視野を見るかもしれません。EHRモデルがある受診記録から学習し、同じ患者の後日の記録でテストされるかもしれません。ウェアラブルモデルでは、同じ記録から切り出した異なる時間窓が別々の分割へ入る可能性があります。
この重複から利益を得るために、モデルが明示的な患者識別子を必要とするわけではありません。共通する解剖学的特徴、調製アーチファクト、スキャナー固有の特徴、文書化パターン、取得条件だけでも十分な場合があります。
分割前に、関連する観測を同じ区分へ保持するグループ化キーを定義してください。ワークフローに応じて、患者、症例、受診、検体、スライド、研究、装置セッション、施設、または他の臨床的に意味のある単位を使用できます。複数の階層が重要な場合は、関連する最も保守的なグループ化が必要になることがあります。
グループ、施設、時系列の分割を意図的に選ぶ
分割戦略が異なれば、答える問いも異なります。
グループ分割
グループ分割では、患者や検体など、1つの単位に属するすべての観測を1つの区分へ保持します。訓練データと評価データの直接的な依存関係を防ぐための最低限の保護になることがよくあります。
施設保持分割
施設保持評価では、開発施設以外へ性能が移転するかを確認します。複数施設を混合したランダム分割では隠れてしまう、対象集団、ワークフロー、装置、ラベリング方法、取得プロトコルの違いを明らかにできます。
施設保持性能を、自動的に普遍的な外的妥当性と表現してはいけません。それは、評価した特定の施設、対象集団、条件についてのエビデンスです。
時系列分割
時系列分割では、過去のデータで訓練し、後のデータで評価します。普及率、文書化、プロトコル、装置、診療の変化を含め、開発日を固定した後の導入をより適切に表現できる場合があります。
同一の患者、症例、派生アーチファクトが境界をまたぐ場合、時間だけでは十分ではありません。グループ制約と時系列制約を組み合わせる必要があります。
取得元または装置のチャレンジセット
意図した範囲に複数のスキャナー、アッセイ、取得システム、運用条件が含まれる場合、取得元ごとに層別化した明示的な評価が必要になることがあります。まれでも重要な条件は、ランダムなテスト標本へ偶然含まれることに頼らず、専用のチャレンジセットを必要とする場合があります。
目的は、最も複雑な設計を選ぶことではありません。意図した用途と主要なリスクを正直に検証できる、最も単純な設計を選ぶことです。
前処理を訓練境界の内側に保つ
分割メンバーシップが正しくても、リークは起こり得ます。
データから学習する処理は、評価データの情報を開発へ移す可能性があります。例として次が挙げられます。
- データセット全体の統計量を使った欠損値補完
- 全体の平均と分散による正規化
- すべてのラベルを使った特徴量選択
- テスト結果を見た後の閾値選択
- コホート全体から導いた規則による外れ値除去
- すべての施設にまたがる画像調和パラメータの学習
- 派生ファイルが分割をまたいだ後でのみ重複排除を行うこと
安全のための原則は次のとおりです。
まず分割し、学習を伴う前処理は訓練データだけで適合させる。
適合済みの変換を検証データとテストデータへ適用することはできますが、それらの区分が変換内容を決めてはいけません。パイプラインツールはこの境界の強制に役立ちますが、コード構造だけでは証明になりません。どの変換を、どのデータセット版で、どの順序で適合させたかを記録すべきです。
データ拡張にも注意が必要です。画像の拡張版は元画像と同じ区分へ保持してください。分割前に派生版を生成し、個別に振り分けると、ほぼ重複したデータによるリークが発生します。
反復には検証セットを使い、最終テストセットを保護する
訓練、検証、テストの各データには異なる役割があります。
- 訓練データは、モデルパラメータと学習を伴う前処理を適合させます。
- 検証データは、アーキテクチャ選択、ハイパーパラメータ調整、閾値選択、早期停止、キャリブレーション判断、候補比較を支援します。
- テストデータは、開発計画が安定した後の性能を推定します。
チームがモデル選択やパイプライン修正のためにテストセットを繰り返し利用すると、そのテストセットは実質的に保持されているとは言えなくなります。記録を訓練データへコピーしていなくても、テスト性能の情報が開発へ影響します。これはテストセットへの過適合です。
実践的なコントロールとして、最終評価前に最終テストセットをロックし、アクセス規則を定義します。テスト結果を確認した後で重要な開発判断を行った場合、その判断を記録し、評価上の主張を再検討すべきです。新しい独立テストセットが必要になることもあります。
交差検証は限られた開発データを有効に使えますが、グループ化要件をなくすものではありません。各フォールドでも、意図した用途に必要な患者、症例、施設、時間の境界を保持する必要があります。フォールド数を増やしても、それだけで外部エビデンスが生まれるわけではありません。
分割メンバーシップをエビデンスとして保持する
訓練、検証、テストにどの標本を使用したか再構成できなければ、モデル結果のレビューは困難です。
データセットの各バージョンについて、次を保持してください。
- 安定した標本またはグループ識別子
- 分割メンバーシップ
- グループ化キーと階層
- 分割戦略と、該当する場合はシード
- 選択基準と除外基準
- 重複関係と派生関係
- 分析に必要な取得元、施設、装置、時間のメタデータ
- 必要に応じてラベル版とレビュー担当者の来歴
- 前処理とデータ拡張の設定
- データセットとコードのバージョン
- 分割に関連する評価計画
これは規制対象ワークフローにおけるAIトレーサビリティの一部です。分割マニフェストは、データの複製、フィルタリング、エクスポート、再ラベリングのたびに変わる非公式な状態ではなく、バージョン管理された成果物であるべきです。
派生データセットを元データセットと公平に比較する場合、分割メンバーシップの保持が不可欠になることがあります。区分を再度ランダム化すると、結果を並べて提示していても、異なる評価上の問いになる可能性があります。
1つの平均スコアを超えて評価する
リークのない分割でも、エビデンスが不完全なことはあります。
次のような、臨床的・運用的に意味のある文脈ごとに性能を確認してください。
- 施設
- スキャナーまたは装置
- 調製または取得プロトコル
- 適切かつ合法な場合の人口統計または臨床サブグループ
- 疾患の有病率または症例構成
- 画像または記録の品質
- 期間
エラーそのものも直接確認してください。予想外に高い性能は警告になることがあります。モデルが、取得元のアーチファクト、結果判明後のフィールド、ファイル名に埋め込まれたラベル、画像に焼き込まれた注釈、ワークフロー上の近道、重複記録を利用しているかもしれません。
モデリング前の集中的なAIデータ準備レビューは、こうしたリスクの発見に役立ちます。導入後はAIモデル監視によって稼働条件とエビデンスのベースラインを比較すべきですが、監視で独立していなかったテストセットを修復することはできません。
データセットが小さい場合はどうするか?
データセットが小さいほど、正直な評価は不要になるのではなく、難しくなります。
グループ化交差検証、集中的なチューニングのためのネスト交差検証、ブートストラップ信頼区間、段階的なエビデンス計画などを利用できます。意図した用途を狭める、判断を固定した後で訓練データと検証データを統合する、外部評価を後の段階へ留保するといった選択肢もあります。
重要なのは、エビデンスが何を支えられ、何を支えられないかを明記することです。不確実性を可視化した小規模でクリーンな評価は、汚染された大規模なテスト結果を偽の精密さで提示するより有益です。
データ不足への対処として、密接に関連する観測を説明なく訓練とテストの境界へまたがせてはいけません。行数は増えますが、結果の意味は弱くなります。
最小限のリーク防止チェックリスト
医療AIの評価を受け入れる前に、次を確認してください。
- 意図した用途と将来の導入環境が定義されている。
- 予測単位と独立単位の両方が明示されている。
- 関連する患者、症例、検体、スライド、受診、セッションが、禁止された境界をまたがない。
- 重複と派生アーチファクトが分割前に特定されている。
- 施設、装置、ワークフロー、時系列の影響が考慮されている。
- 学習を伴う前処理と特徴量選択が訓練データだけで適合されている。
- チューニングと閾値判断には検証データが使用されている。
- 最終テストセットにアクセス規則があり、開発用ダッシュボードとして使われていない。
- 分割メンバーシップ、グループ化ロジック、除外、バージョン、シードが保持されている。
- 結果に不確実性、文脈別性能、失敗レビューが含まれている。
- テスト後の開発判断がすべて記録されている。
- 外部評価に関する主張が、実際に調査した対象集団と環境に限定されている。
信頼できる評価はワークフローの性質である
データリークは、1行のコードだけで防止できるものではありません。データ受け入れ、ラベリング、データセットのバージョン管理、実験、レビュー、エビデンス管理を横断する連携が必要です。
優れたチームは、評価境界を早期に明示します。データの移動中もその境界を保持し、不審な性能を調査し、日常的な反復から最終テストセットを分離します。これによってモデルの導入成功が保証されるわけではありません。しかし、エビデンスをより正直で、再現可能で、次の判断に役立つものにできます。
医療AIのベンチマークまたは検証研究を準備している場合、ModAsteraは、モデル比較の手戻りが大きくなる前に、データセット構造、分割ロジック、エビデンス準備状況をレビューする支援を提供できます。