医療AIモデルは、確率のようなスコア、類似度、または信頼度を表す連続値を出力することがあります。しかし、ワークフローには、その次に何を行うかを定めるルールがなお必要です。
症例に優先順位を付けるのか、二次レビューに回すのか、陰性とするのか、保留するのか、あるいは追加のエビデンスを得るためにエスカレーションするのか。スコアだけでは、この問いに答えられません。答えを与えるのは、明確に定義された使用目的、対象集団、誤りのトレードオフ、人が担うプロセスに結び付いた運用点、すなわち1つまたは複数の閾値です。
この区別が重要なのは、技術的に優れたモデルであっても、選択した運用点では十分に機能しない場合があるためです。症例を適切に順位付けできても、誤警報が多すぎたり、重要な症例を見逃しすぎたり、対応可能なレビューチームの処理能力を超えたりする可能性があります。レビュー可能な閾値設定プロセスによって、保護された評価を行う前、そしてスコアに基づいてアクションを起こす前に、こうした帰結を明示できます。
モデルスコアだけでは意思決定にならない
スコアは、モデルが学習した内容に従って症例を順位付けしたり分離したりします。閾値は、そのスコアを陽性、陰性、要レビュー、保留などの状態に変換します。
この変換は方針上の選択です。モデルだけでは答えられない、次のような問いに左右されます。
- 各状態の後には、どのようなアクションが続くのか。
- 偽陰性はどのような結果をもたらすのか。
- 偽陽性には、どの程度のコストと作業負荷が伴うのか。
- 不確実な症例に対応できる有資格のレビュー担当者がいるのか。
- どの程度の速さで意思決定する必要があるのか。
- この方針は、どの対象集団と環境を対象とするのか。
後ろ向き研究では許容できる閾値でも、専門家の対応能力が限られたキューでは運用できない場合があります。優先順位付けのために設計された閾値は、疾患を除外する目的には不適切かもしれません。したがって、同じモデルでも、意図された使用目的が異なれば異なる運用方針が必要になることがあります。ただし、それらの方針を混同したり、相互に置き換え可能であるかのように説明したりしてはいけません。
閾値を選ぶ前に、意図するアクションを定義する
閾値の選択は、好みの評価指標ではなく、ワークフローを記述することから始めるべきです。
利用者、対象集団、入力、出力、利用環境、アクションを明確にします。そのうえで、モデルが取り得る各状態の意味を定義します。たとえば、範囲を限定したレビューワークフローでは、2つの閾値を使って次の3つの状態を設けることが考えられます。
- 症例をキューの前方に移す高優先度の状態、
- 通常どおりのレビューを維持する通常の状態、
- 別の読影者または追加のエビデンスを求める中間の不確実性帯。
これは、1つの閾値を使うより自動的に安全になるという意味ではありません。各状態について、担当者、応答時間、文書化されたフォールバックが定められている場合にのみ有用です。担当者のいない棄権用の区分は、未解決の作業を見えなくするだけです。
グラウンドトゥルースと参照標準のプロセスも、そのアクションに合致していなければなりません。モデルの目的が臨床レビューの優先順位付けであるなら、目的ラベル、追跡期間、意思決定単位は、関係の薄い代替指標ではなく、その問いを支えるものであるべきです。
識別能、キャリブレーション、運用点での分類を分けて考える
次の3つの概念は、しばしば1つにまとめて扱われます。
- 識別能は、リスクの高い症例が、リスクの低い症例より高いスコアを得る傾向にあるかを問います。
- キャリブレーションは、予測リスクが、定義された対象集団と状況における観測頻度に対応しているかを問います。
- 運用点での分類は、閾値を適用した後に、どのような感度、特異度、予測値、アラート件数、誤りのパターンが生じるかを問います。
モデルは、高い識別能を示しながら、キャリブレーションが不十分な場合があります。[1] また、平均的にはキャリブレーションされていても、ワークフローにとって重要な閾値では十分な性能を示さないこともあります。これらの特性は、いずれも互いの代わりにはなりません。
したがって、裏付けとなるキャリブレーションのエビデンスがない限り、ニューラルネットワークの生の出力を臨床的な確率として示すべきではありません。また、AUROCによって運用点が決まるわけでもありません。AUROCは複数の閾値にわたる順位付けを要約しますが、ワークフローには、選択した1つまたは複数の運用点における文書化された方針がなお必要です。
評価指標全般については、正解率だけに頼らない医療AIモデル評価も参照してください。
保護されたテストではなく、開発または検証のエビデンスで選択する
最終テストの結果を確認してから、混同行列が良く見えるまで閾値を動かし、その調整後の結果を独立した評価であるかのように報告することがあります。このような手順では、テストコホートが開発データになってしまいます。
より妥当性を説明しやすい手順は、次のとおりです。
- 意図された使用目的と、候補となる閾値選択ルールを定義する。
- 使用が認められた開発データを用いて、モデルとキャリブレーション変換を当てはめる。
- 検証のエビデンスに基づいて、候補となる運用点を比較する。
- 事前に定めた技術面とワークフロー面の基準を用いて、運用点を選択する。
- モデル、前処理、キャリブレーション、閾値、解析コードを固定する。
- 固定した一式を保護されたデータで評価する。
具体的なデータ構成は異なり得ますが、原則は変わりません。保護されたデータによる評価結果は、意思決定方針を固定した後の性能を推定するために使うべきです。その結果を受けて方針を変更した場合、評価に基づいて主張できることの強さも変わります。
この原則は、データ漏洩を防ぐ訓練、検証、テストの分割と併せて考える必要があります。分割の完全性が対象とするのは、フォルダ内の行だけではありません。運用閾値を含め、結果の影響を受けたあらゆる選択が対象です。
候補となる運用点での帰結を定量化する
感度と特異度は必要ですが、ワークフローには件数と処理能力の把握も必要です。
候補となる各閾値について、次の項目を検討します。
- 真陽性、偽陽性、真陰性、偽陰性、
- 評価対象の有病率における陽性的中率と陰性的中率、
- 手動レビューに回される症例、
- 1日または1週間当たりに見込まれるレビュー件数、
- 所要時間への影響、
- 施設、デバイス、サブグループ、入力品質層別の誤り、
- 必要に応じて、信頼区間と再サンプリング間の不安定性。
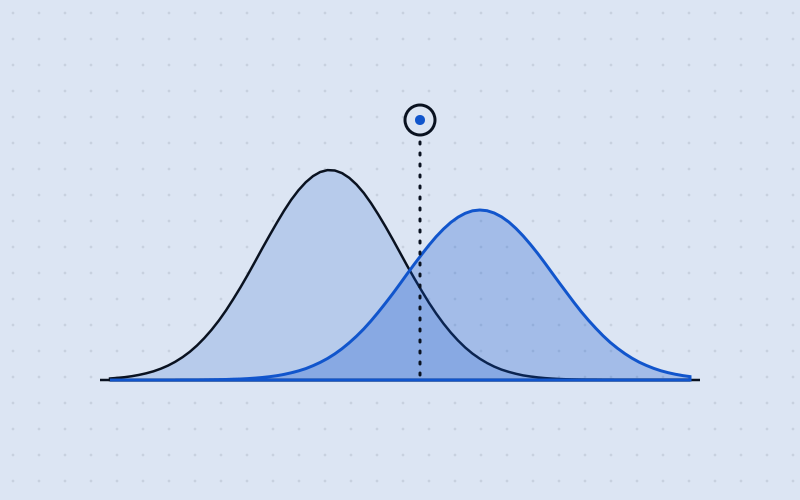
感度を高める閾値は、誤警報の件数も増やす可能性があります。そのトレードオフを許容できるかどうかは、症例を見逃した場合の重大性、追加レビューの負担、次に行うアクションによって異なります。決定曲線分析は、閾値に関する選好を純便益に結び付ける枠組みの1つですが、臨床面と運用面の判断が不要になるわけではありません。[2]
絶対数は特に重要です。割合が小さくても、本番環境の件数では処理不能なキューが生じることがあります。反対に、感度の向上が一見わずかでも、見逃した症例の重大性が高い場合には重要な意味を持ち得ます。判断は、見栄えのよい評価指標に最適化するのではなく、実際のワークフローに結び付けるべきです。
不確実性とエスカレーションを設計された状態として扱う
すべての症例を1つの二値境界で強制的に分類すべきではありません。
不確実性は、入力品質の低下、情報の欠落、参照標準における不一致、開発時の分布からの隔たり、運用点に近いスコアなどから生じる可能性があります。これらは異なる状態であり、それぞれに異なる対応が必要となる場合があります。
レビュー可能な方針では、次の項目を定義できます。
- 推論前に品質管理で棄却する条件、
- 信頼度が低い、または判定不能とする範囲、
- 有資格の二次レビュー担当者に回す経路、
- 別のモダリティまたはエビデンス源を求める手順、
- 入力が適用範囲外となった場合の使用停止条件。
人が担う役割は、具体的でなければなりません。ヒューマン・イン・ザ・ループを用いた規制対象ワークフローは、承認ボタンを追加するだけでは成立しません。チームには、責任の所在、エスカレーション基準、監査状態に加え、オーバーライドと未解決の症例を測定する方法が必要です。WHOのガイダンスも同様に、医療AIガバナンスにおける説明責任と人の責任を重視しています。[4]
運用点に関する完全な契約を固定する
背景情報のない閾値は、再現可能なエビデンスではありません。
固定する記録では、次の項目を特定する必要があります。
- モデルとチェックポイントのバージョン、
- 前処理と入力品質のルール、
- スコアの定義とクラスの向き、
- キャリブレーション方法と当てはめに用いたコホート、
- 閾値、または閾値選択ルール、
- 検証コホートと参照標準のバージョン、
- 評価指標、信頼区間、サブグループの確認、
- 意図された利用者、アクション、除外条件、フォールバック、
- コードと設定のバージョン、
- 承認責任者と発効日。
この契約は、見過ごされやすい不具合を防ぎます。同じモデルの重みを使用する2つのシステムでも、前処理、スコアの向き、キャリブレーション、閾値設定が異なれば、異なるアクションにつながる可能性があります。
透明性の高い報告によって、レビュー担当者は実際に何が評価されたのかを把握しやすくなります。TRIPOD+AIは、回帰または機械学習の手法を用いた予測モデルの報告枠組みを提供し、意図された使用目的、手法、評価を明確に記述する必要性を強調しています。[3]
黙って再調整せず、他環境への適用可能性を再確認する
ある施設で選択した運用点は、有病率、取得条件、症例構成、ワークフロー、参照標準が異なるため、別の施設では挙動が変わる可能性があります。キャリブレーションも、対象集団や時間の経過に伴って変化することがあります。[1]
外部評価では、まず、固定した方針をそのまま移した場合の性能を測定すべきです。性能が適切でない場合は、再キャリブレーション、閾値の改定、適用範囲の制限を検討できますが、それは新たな開発上の意思決定です。外部テストコホートを、改善した閾値を得るための情報源として密かに利用しながら、手を付けていない検証データであるかのように説明してはいけません。
同じ区別は、デバイスや対象集団が異なる場合にも当てはまります。他環境への適用可能性を検証する全体的なワークフローについては、医療AIの外部検証を参照してください。
リリース後も運用点をモニタリングする
閾値は不変の事実ではありません。入力条件、有病率、レビュー対応能力、下流のアクションは変化する可能性があります。
モニタリングでは、次の項目を追跡できます。
- スコア分布と入力品質上の不具合、
- アラート率と棄権率、
- 手動レビューの件数と所要時間、
- オーバーライドとエスカレーションの結果、
- 遅れて得られる結果と関連付けた感度と誤警報の負担、
- サブグループ別および施設別の性能低下、
- 有病率または参照標準の運用の変化。
アラート件数の変化だけで、モデルドリフトが証明されるわけではありません。これは、データ、ワークフロー、ソフトウェア、対象集団、ラベルの変化を調査するためのシグナルです。対応は、管理されたプロセスに従うべきです。新たな検証計画を立てずに最近の不具合に合わせて閾値を再調整すると、目に見える1つの問題を、測定されていない別の問題に置き換える可能性があります。
そのため、規制対象ワークフローにおけるモデルモニタリングでは、モデルの稼働時間や入力ドリフトだけでなく、意思決定方針も対象にすべきです。
実務で使える閾値レビュー記録
スコアによってワークフローを制御する前に、レビュー担当者は次の問いに答えられる必要があります。
- 運用点は、どのアクションと対象集団を対象としているか。
- どの誤りが最も重要で、誰がそのトレードオフを承認したか。
- 明示された解釈に合わせてスコアがキャリブレーションされていたか。
- モデル、キャリブレーション、閾値の選択には、どのデータが使われたか。
- 契約全体が固定されるまで、保護された評価には手を付けなかったか。
- どのような感度、特異度、予測値、件数、作業負荷が生じるか。
- どのサブグループ、施設、デバイス、品質層を確認したか。
- 不確実、評価不能、適用範囲外の症例はどうなるか。
- どのアーティファクトのバージョンによって結果を再現できるか。
- どのモニタリングシグナルを契機として、レビュー、制限、再キャリブレーション、運用終了を行うか。
MAEAは、このライフサイクル全体にわたって、実験、アーティファクト、データセット、エビデンスの記録を関連付けて管理できるよう設計されています。プラットフォームは、運用点に関する契約を検証可能な状態に保つうえで役立ちますが、臨床、統計、品質、ワークフローに関する意思決定は、有資格のチームが引き続き責任を負います。
したがって、医療AIの閾値は、評価指標の報告書に隠された魔法の数字ではありません。モデルのエビデンスと人のアクションをつなぐ、レビュー可能な橋です。統制され、バージョン管理された方針として扱うことで、技術的な結果とワークフローに関する主張の両方を検証しやすくなります。